探索智能决策新边界 AIClub第九期沙龙聚焦强化学习与AI赋能产品
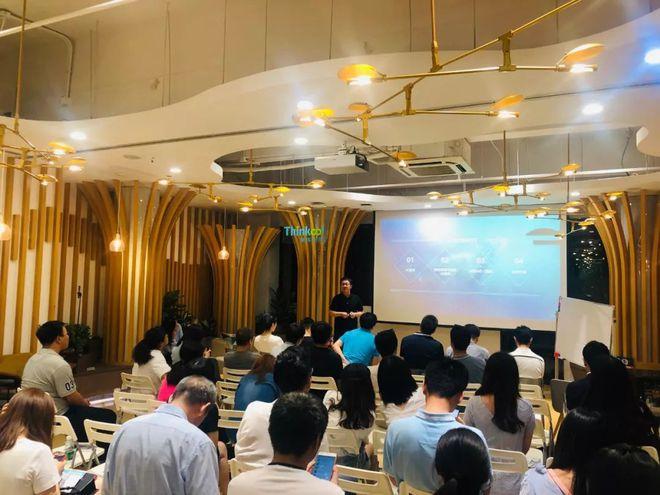
由AIClub主办、备受期待的第九期技术交流沙龙《强化学习与AI赋能产品》在北京成功举办。本次活动汇聚了来自学术界、工业界的数十位AI专家、算法工程师和产品经理,围绕强化学习(Reinforcement Learning, RL)的前沿进展、落地挑战以及如何利用RL为产品注入智能决策能力,展开了深度分享与激烈讨论。
沙龙伊始,主办方AIClub负责人表示:“强化学习正从游戏博弈、机器人控制等经典场景,加速渗透到推荐系统、智能调度、自动驾驶乃至大语言模型对齐等产品化领域。如何将RL的理论优势转化为用户可感知的产品价值,是当下极具挑战也充满机遇的方向。”
上半场:强化学习技术前沿与实战复盘
首位分享嘉宾是来自某头部大厂的资深算法专家李博士,他带来了题为《从Sim到Real:强化学习在复杂决策系统中的落地实践》的演讲。李博士结合团队在智能物流调度和资源分配中的经验,指出强化学习落地面临的三重鸿沟:仿真与现实差异、样本效率瓶颈、以及安全约束的满足。他详细介绍了如何通过离线强化学习、基于模型的方法以及安全层设计来逐步弥合这些差距,并展示了一个真实案例:通过RL优化仓储机器人路径规划,使分拣效率提升了23%。
来自高校的RL研究者王教授分享了《多智能体强化学习:合作、竞争与涌现行为》的学术报告。王教授从博弈论视角出发,阐述了多智能体环境下的非平稳性挑战,并展示了其团队在StarCraft II、自动驾驶车队协同等环境中取得的最新成果。他特别提到:“多智能体强化学习的真正难点不在于算法本身,而在于如何设计有效的信用分配和通信机制。这对于未来构建多AI协作的产品生态至关重要。”
茶歇交流:Demo演示与观点碰撞
茶歇期间,与会者亲身体验了两个基于强化学习的产品原型:一个是自适应游戏关卡难度调节系统,能够根据玩家实时表现动态调整关卡参数,提升留存;另一个是智能客服对话策略优化Agent,通过RL训练对话策略以最大化用户问题解决率。现场气氛热烈,多位产品经理就“RL训练成本过高”、“策略难以解释”等问题与分享嘉宾进行了深入交流。
下半场:AI赋能产品的设计思维与落地框架
短暂休息后,沙龙进入产品向议题。一位资深AI产品总监赵女士分享了《强化学习产品的设计拉锯战:在用户价值与算法约束之间》。她直言,最容易犯的错误是“强行RL”——即用传统的SL(监督学习)思路去套RL问题。她提出了一套RL产品化的四步框架:一、定义序贯决策问题(是否真的需要RL?);二、设计可量化的奖励函数(需业务与算法共识);三、确保安全的探索策略(避免影响用户体验);四、建立长周期评估体系(注重复合指标而非单步回报)。赵女士还举例,某视频流产品曾尝试用RL优化推荐序列多样性,初期CTR下降但长期贡献度上升,最终通过设置短中期混合奖励平衡了即时体验和长期留存。
两位来自创业公司的技术负责人进行了一场“博弈论与RL在交易产品中的应用”对谈。他们讨论了如何利用逆向强化学习从历史交易数据中提取隐藏的用户效用函数,以及在线拍卖场景下的机制设计(Mechanism Design)与RL调控之间的关系。现场金句频出,例如:“如果奖励函数里没有惩罚假阳性的成本,AI就会学会说谎。”
圆桌讨论:强化学习的确定性未来
在圆桌环节,与会嘉宾就“强化学习会成为通用人工智能的必经之路吗?”展开辩论。乐观方认为,随着算力提升和世界模型进步,RL有望解决更长上下文的战略规划问题;谨慎方则提醒,仿真到现实的鸿沟、样本利用率的指数级差距可能长期存在,未来5-10年将是混合智能(RL+知识+因果推断)的实用阶段。
AIClub为每位参与者提供了RL学习路径图与预训练资料包。主持人道:“强化学习不像监督学习那样可直接短平快落地,但它代表了一种产品智能化升级的底层能力——让系统自治地做出最优决策。今天的每一场碰撞,都是在为真正的智能产品铺路。”
据悉,AIClub将持续举办开放技术沙龙,第十期将聚焦“具身智能与多模态世界模型”。本次沙龙在热烈掌声中圆满落幕,与会者普遍表示,这种深度切磋为技术与商业的双向赋能提供了宝贵启发。
如若转载,请注明出处:http://www.kgtlq.com/product/93.html
更新时间:2026-10-11 10:33:30